

Erfundene URLs aus ChatGPT: 404-Aufrufe im Logfile finden und mit Weiterleitungen abfangen

ChatGPT nennt in seinen Antworten Produkte, Händler und Ratgeber und verlinkt sie. Nicht jeder dieser Links führt auf eine Seite, die es gibt: Manche URLs setzt ChatGPT selbst zusammen, und der Besucher landet auf einer 404-Seite. Bei großen Websites kommt dabei Traffic an, den niemand sieht, weil er weder in der Search Console noch zuverlässig in Analytics auftaucht. Im Server-Logfile findest du diese Aufrufe, und viele davon fängst du mit wenigen Weiterleitungen ab.
Das Beispiel: ein Fliesenkleber bei Hornbach
Auf die Frage nach einem Kleber für einen Fliesentisch hat mir ChatGPT den Soudal Fix ALL Floor & Wall in 4 kg für 41,95 € empfohlen, mit dem Hinweis „Bei Hornbach + weitere“. Produkt, Preis und Händler stimmen, der Link „Bei Hornbach ansehen“ führt aber auf eine 404-Seite.
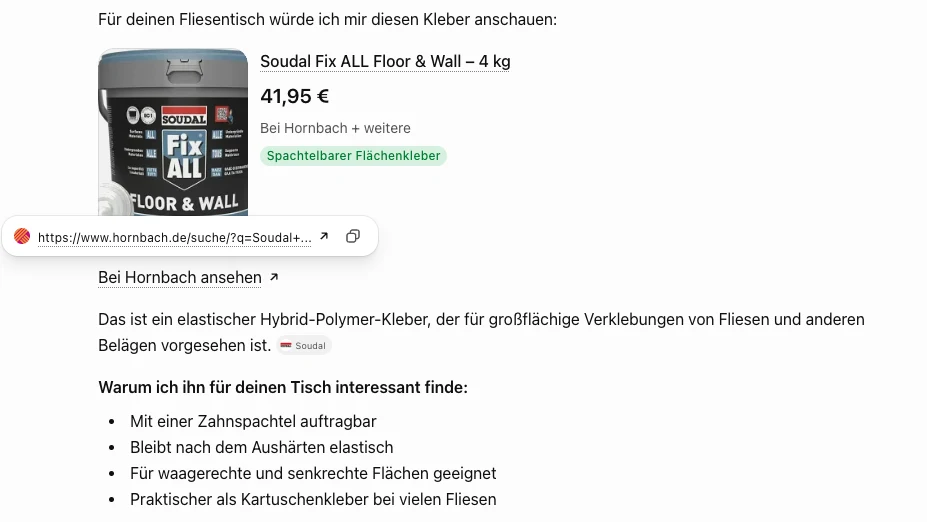
Die Adresse lautet hornbach.de/suche/?q=Soudal+Fix+ALL… und ist bei Hornbach nicht vergeben. Die Suche liegt dort unter /s/ mit dem Suchbegriff im Pfad. Am 09.11.2026 habe ich beide Varianten im Browser aufgerufen: /suche/?q=Soudal+Fix+ALL+Floor+%26+Wall antwortet mit Status 404 und dem Seitentitel „Seite nicht gefunden.“, /s/soudal fix all mit Status 200 und den Suchergebnissen.
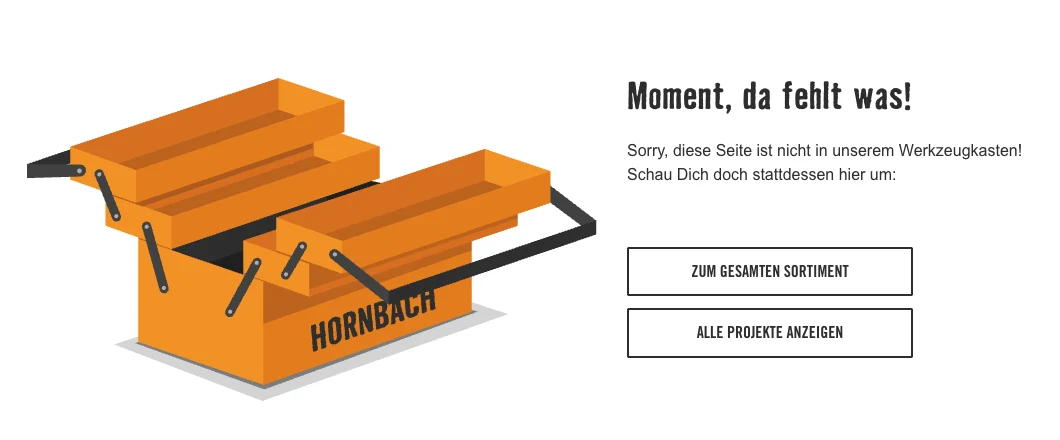
Hornbachs Fehlerseite verweist immerhin auf das Sortiment und die Projekte. Den Suchbegriff aus der URL nutzt sie nicht, der Besucher muss also neu suchen.
Veraltete Adresse oder erfundene URL
Ein Link aus einer KI-Antwort endet aus zwei Gründen auf einer 404-Seite. Entweder hat die Seite früher existiert und ist ohne Weiterleitung weggefallen, oder ChatGPT hat die URL nach einem Muster gebaut, das es auf der Website nie gab. Für die Lösung macht das einen Unterschied: Eine weggefallene Seite ist ein klassischer Fehler aus einem Relaunch oder einer Sortimentsänderung, eine erfundene URL folgt oft einem Schema, das sich wiederholt.
Ob eine Adresse früher existiert hat, prüfst du im Webarchiv. Für hornbach.de liefert die Wayback Machine unter /suche/ keinen einzigen archivierten Treffer. Es spricht also nichts dafür, dass Hornbach dieses Muster je genutzt hat.
Wie ChatGPT den Link im Einzelnen zusammensetzt, legt OpenAI nicht offen. Das Ergebnis passt aber zu einem naheliegenden Schema: „Suche“ als Pfad und q als Parameter für den Suchbegriff sind auf vielen Websites üblich. Ahrefs beschreibt dasselbe bei erfundenen Pfaden auf der eigenen Domain wie /blog/internal-links/: Sie passen zum Aufbau der Website, existieren aber nicht.
Wie oft KI-Antworten auf 404-Seiten verlinken
Ahrefs hat im September 2025 rund 16 Millionen URLs aus Antworten von ChatGPT, Perplexity, Copilot, Gemini, Claude und Mistral ausgewertet. Von den geklickten Links aus ChatGPT führten 1,01 % auf eine 404-Seite, bei Google waren es 0,15 %. Über alle KI-Assistenten lag der Schnitt bei 0,43 %, also beim 2,87-Fachen von Google.
Gezählt hat Ahrefs dabei Seiten, deren Titel „404“ oder „not found“ enthält. Fehlerseiten mit anderem Titel wie „Moment, da fehlt was“ fallen durch dieses Raster, die tatsächlichen Werte liegen also eher höher. In einem zweiten Test über die zitierten statt der geklickten URLs kam ChatGPT auf 2,38 %.
Bekommt ein Shop im Monat 3.000 Besuche aus ChatGPT, landen bei 1 % rund 30 davon auf einer Fehlerseite, oft direkt aus einer Kaufempfehlung.
404-Aufrufe aus KI-Antworten im Logfile finden
Die Aufrufe findest du am zuverlässigsten im Server-Logfile, gefiltert auf Status 404 und Herkunft aus einem KI-Assistenten. Analytics zeigt nur einen Teil davon, die Search Console in der Regel gar nichts.
Analytics erfasst einen Besuch in einem üblichen Setup mit Consent-Banner nur, wenn der Besucher dem Tracking zugestimmt hat und die Fehlerseite überhaupt misst. Die Search Console meldet 404-Fehler, die der Googlebot findet, und eine URL, die nur in einer ChatGPT-Antwort existiert, crawlt er in der Regel nicht. Im Logfile steht dagegen jeder Aufruf mit Status, URL und Referrer.
Besucher aus ChatGPT erkennst du an zwei Merkmalen: am Referrer https://chatgpt.com/ und am Parameter utm_source=chatgpt.com, den ChatGPT an Links anhängt. In meiner Stichprobe zu ChatGPT Shopping trugen alle 473 Händler-Links diesen Parameter. Der Parameter ist der sicherere Filter, weil er in der Request-Zeile steht, auch wenn eine App keinen Referrer mitschickt.
Für ein Logfile im verbreiteten Combined-Format von nginx oder Apache listet dieser Befehl die häufigsten 404-URLs aus ChatGPT, Perplexity, Gemini, Copilot und Claude. Suchbegriffe im Parameter q fasst er zu einem Sternchen zusammen, damit Muster sichtbar werden:
awk '$9 == 404' access.log \
  | grep -E 'utm_source=chatgpt\.com|"https://(chatgpt\.com|www\.perplexity\.ai|gemini\.google\.com|copilot\.microsoft\.com|claude\.ai)' \
  | awk '{print $7}' \
  | sed -E 's/([?&]q=)[^&]*/\1*/' \
  | sort | uniq -c | sort -rn | head -50
Ältere, gepackte Logfiles liest du mit zcat statt mit awk direkt ein. Läuft die Website hinter einem CDN wie Cloudflare oder Akamai, liegen die vollständigen Logs dort und nicht auf dem eigenen Server. Willst du Crawler sicher ausschließen, filterst du zusätzlich die User-Agents OAI-SearchBot und ChatGPT-User heraus.
Sortiere das Ergebnis nicht nach einzelnen URLs, sondern nach Verzeichnis und Parameter. Zwanzig verschiedene Suchbegriffe unter /suche/?q= sind ein Fehler mit einer Lösung, keine zwanzig Fehler.
Muster per Weiterleitung abfangen
Wiederkehrende Muster fängst du mit einer Regel ab, einzelne erfundene URLs leitest du auf die passende Seite. Im Hornbach-Beispiel reicht eine Weiterleitung von /suche/?q=begriff auf /s/begriff, und jeder künftige Link nach diesem Muster landet in der Suche.
In nginx sieht das so aus:
location = /suche/ {
    if ($arg_q) {
        return 301 /s/$arg_q;
    }
    return 404;
}
$arg_q übernimmt den Suchbegriff so, wie er in der URL steht, Leerzeichen also als Pluszeichen oder %20. Prüfe vor dem Livegang, ob deine Suche beide Schreibweisen versteht. Suchergebnisseiten stehen meist auf noindex, die Weiterleitung dient also den Besuchern und nicht dem Ranking.
Für einzelne erfundene Produkt-, Kategorie- oder Ratgeber-URLs gilt das übliche Vorgehen aus jedem Relaunch: eine 301-Weiterleitung auf die Seite, die der Besucher erwartet hat, also das Produkt, die Kategorie oder den Ratgeber zum Thema. Leite nicht alles pauschal auf die Startseite. Der Besucher findet dort nicht, was er gesucht hat, und Google kann Weiterleitungen auf unpassende Seiten als Soft 404 werten.
Wo eine Weiterleitung nicht möglich ist, hilft eine bessere Fehlerseite: Steht der Suchbegriff in der URL, kann die 404-Seite ihn auslesen und direkt passende Ergebnisse oder eine vorausgefüllte Suche zeigen. Den Statuscode 404 behält sie dabei.
Wann sich die Prüfung lohnt
Die Prüfung lohnt sich vor allem für große Websites mit vielen Besuchern aus KI-Assistenten, also für Shops mit großem Sortiment, Marktplätze und Publisher. Ahrefs setzt die Schwelle für eine Weiterleitung bei mehr als zehn Besuchern im Monat je URL, bei Mustern lohnt sie sich schon früher, weil eine Regel alle künftigen Varianten abdeckt. Ein großer Wachstumshebel ist das nicht, aber der Aufwand ist klein.
Für den Alltag reicht ein fester Rhythmus:
Einmal im Monat filtern.
Den Befehl oben auf die Logs des Vormonats anwenden und die Liste nach Mustern sortieren.
Weggefallene Seiten zuerst.
URLs, die früher existiert haben, gehören ohnehin weitergeleitet, unabhängig von ChatGPT. Das ist klassisches Technical SEO.
Muster mit einer Regel abfangen.
Such-URLs, Sprachpfade oder falsche Verzeichnisse mit einer Weiterleitungsregel lösen.
Einzelne URLs nach Traffic.
Erfundene Einzel-URLs nur weiterleiten, wenn sie regelmäßig Besucher bringen und es eine passende Zielseite gibt.
Die Weiterleitungen sind ein Auffangnetz, solange KI-Assistenten URLs nach Muster zusammensetzen. Wie ChatGPT im Web sucht und welche Seiten es zitiert, steht im Artikel SEO für ChatGPT; ob die KI-Crawler deine Seiten überhaupt abrufen dürfen, prüft der AI-Crawler-Check. Saubere Weiterleitungen und Statuscodes gehören zu den Basics im Technical SEO.
Häufige Fragen zu erfundenen URLs aus ChatGPT
Warum verlinkt ChatGPT auf Seiten, die es nicht gibt?
Es gibt zwei Ursachen: Entweder hat die Seite früher existiert und ist ohne Weiterleitung weggefallen, oder ChatGPT setzt eine URL nach einem Muster zusammen, das auf der Website gar nicht vorkommt. Im Hornbach-Beispiel ist es das zweite: Die Such-URL /suche/?q= taucht in keinem archivierten Stand der Website auf.
Wie erkenne ich Besucher aus ChatGPT im Logfile?
Am Referrer chatgpt.com oder am Parameter utm_source=chatgpt.com in der aufgerufenen URL. ChatGPT hängt den Parameter an Links an, in meiner Stichprobe vom 30.10.2026 trugen ihn alle 473 Händler-Links. Fehlt der Referrer, etwa in einer App, bleibt der Parameter in der Request-Zeile stehen.
Zeigt die Google Search Console diese 404-Fehler?
Meist nicht. Die Search Console meldet 404-Fehler, die der Googlebot findet. Eine URL, die ChatGPT nur in einer Antwort erzeugt und die nirgends verlinkt ist, crawlt der Googlebot in der Regel nicht. Sichtbar wird sie im Server-Logfile, sobald jemand den Link anklickt.
Sollte ich jede erfundene URL weiterleiten?
Nein, nur URLs mit nennenswertem Traffic und nur auf eine Seite, die zum Inhalt passt. Wiederkehrende Muster wie eine falsche Such-URL fängst du mit einer einzigen Regel ab. Pauschal auf die Startseite weiterzuleiten, hilft Besuchern nicht, und Google kann solche Weiterleitungen als Soft 404 werten.
Let's talk
Wenn du wissen willst, wie viele Besucher aus ChatGPT bei dir auf Fehlerseiten landen und welche Weiterleitungen sich lohnen: Schreib mir kurz, um welche Website es geht. Der Austausch ist unverbindlich.
Oder direkt per WhatsApp:
WhatsApp-Chat starten